一、会议简介
全国社会媒体处理大会(China National Conference on Social Media Processing)由中国中文信息学会社会媒体处理专业委员会主办,专注于以社会媒体处理为主题的科学研究与工程开发,为传播社会媒体处理最新学术研究与技术成果提供广泛的交流平台,旨在构建社会媒体处理领域的产学研生态圈,成为中国乃至世界社会媒体处理的风向标。全国社会媒体处理大会创办于 2012 年,每年举办一次,现已成为社会媒体处理领域的重要学术活动。
第十四届全国社会媒体处理大会(SMP 2026)将于 2026 年 11 月 12 ~ 15 日在北京召开,由中国传媒大学媒体融合与传播国家重点实验室承办。大会主题是“大模型驱动人机共生”,旨在探索大模型日益普及的今天,大模型与人类社会深度共生的途径,聚焦大模型和智能体技术如何赋能人机协同的价值释放。
二、会议安排
会议时间:2026 年 11 月 12 日-15 日
2026 年 11 月 12 日-13 日:前沿技术讲习班
2026 年 11 月 14 日-15 日:主会议(特邀报告、分论坛等)
会议地点:北京辽宁大厦
会议官网:http://smp2026.cips-smp.org/
三、论坛简介
本论坛聚焦大模型强化学习的前沿进展与关键挑战,围绕强化学习在大模型对齐、推理增强、智能体决策等方向的核心作用展开深入探讨。论坛将汇聚学术界与产业界专家,共同分享最新研究成果与实践经验,剖析奖励建模、策略优化、训练稳定性与可扩展性等关键技术难题,并展望强化学习驱动大模型能力持续演进的未来路径
论坛主题:大模型强化学习分论坛
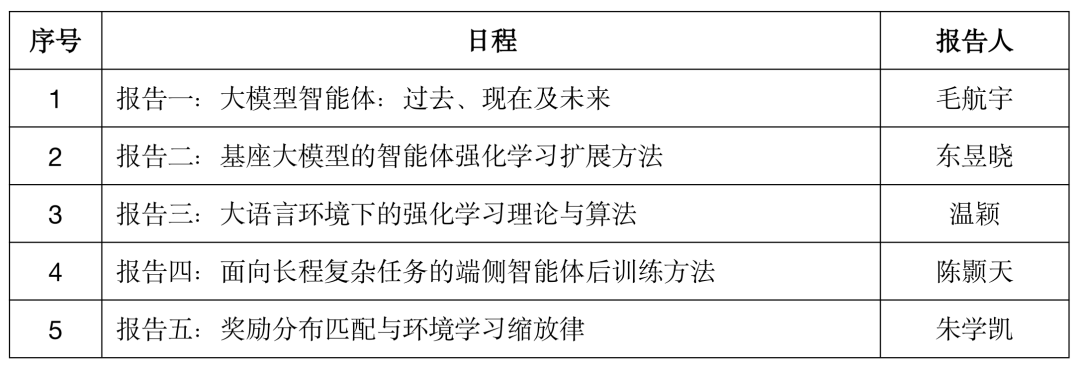
论坛日程:
论坛主席:
/ 钱 忱 /
钱忱,上海交通大学人工智能学院副教授,博士生导师,2021年获得清华大学工学博士学位,研究方向包括大语言模型、自主智能体、多智能体系统。
四、报告信息
一、大模型智能体:过去、现在及未来
/ 毛航宇 /
嘉宾简介:毛航宇,中国科学院微电子研究所研究员、博士生导师、AI 中心副主任。研究方向涵盖大模型、强化学习、智能体系统及AI芯片架构。提出 ARPO(Agentic Reinforced Policy Optimization)和 TPTU(Task Planning and Tool Usage)等大模型智能体训练新范式,有效提升智能体复杂推理和工具调用能力。主持多项人工智能及集成电路领域项目,累计获批经费超 1 亿元。本人和团队曾获全球数字经济大会大模型场景应用典型案例、国际人工智能会议 NeurIPS 强化学习竞赛冠军、中国计算机学会多智能体研究优博奖。曾于互联网科技企业担任研发团队负责人,主导的智能体产品实现用户与月活均突破千万,达成规模化落地。他始终致力于打通“应用-算法-系统-芯片”的软硬协同全链路,推动 AI 智能体在真实场景中创造价值。
报告摘要:以 ChatGPT 为代表的大语言模型是人工智能领域最火爆的研究热点之一,而智能体(AI Agent)是大模型最有潜力的应用方式之一。本报告首先梳理大模型智能体的发展脉络,其次介绍一些典型的智能体技术,尤其是智能体强化学习(Agentic RL)后训练技术,最后分享一些科研体会和思考。
二、基座大模型的智能体强化学习扩展方法
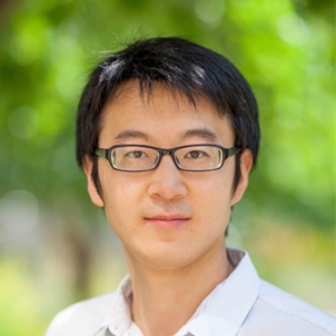
/ 东昱晓 /
嘉宾简介:东昱晓,清华计算机系副教授,主要研究方向是大模型预训练、强化训练、数据挖掘,曾工作于脸书人工智能和微软总部研究院。谷歌引用 4.9 万次,十余篇技术工作引用超 1000 次,开源模型 GitHub 星标数超 11 万。在超大规模预训练与强化扩展训练方面研发关键技术与算法,应用于 GLM-5/5.1/5.2 等系列模型,作为第二完成人获北京市科学技术进步奖一等奖、中国电子学会科技进步一等奖。获 SIGKDD 青年科学家奖(亚洲唯一)、首届 KDD China 青年科学家奖、清华大学“清韵烛光-我最喜爱的教师”(每两年 10 位)。
报告摘要:基础大模型在意图理解、深度推理、目标规划等方面展现出强大的泛化能力,为智能体的研究和应用提供了通用模型基座。报告将分享我们在基座大模型智能体强化扩展学习方向的探索。在训练框架方面,提出多轮、多任务智能体强化学习框架 AgentRL,支持异步高效训练,实现异构环境的可扩展强化学习;在基础能力层面,设计面向长程代码智能体的强化学习算法 SAO 及上下文压缩算法 CompactionRL,提升智能体基座模型的长程推理与规划能力;在应用场景层面,构建手机智能体 MobileRL、上网智能体 WebRL、电脑操作智能体 ScaleCUA,提升大模型在复杂智能体任务中的交互能力。
三、大语言环境下的强化学习理论与算法
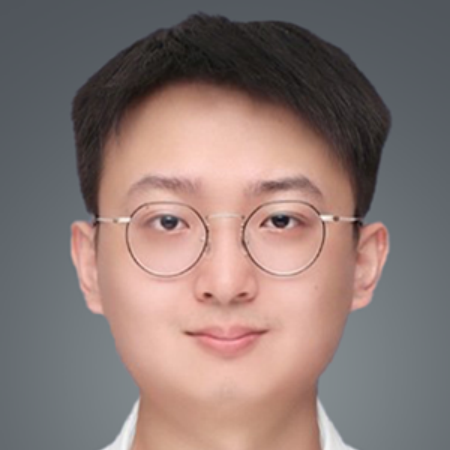
/ 温 颖 /
嘉宾简介:温颖,上海交通大学人工智能学院长聘教轨副教授,上海创智学院全时导师。他的研究方向涉及强化学习、多智能体系统及决策大模型。他于 2020 年和 2016 年分别获得英国伦敦大学学院计算机系博士学位和研究型硕士学位,入选上海海外高层次人才,作为负责人主持自然科学青年基金,国家重点研发计划课题,上海市科学智能百团百项,上海市青年科技英才扬帆计划。他的五十余篇研究成果发表在 ICML, NeurIPS, ICLR, IJCAI, AAMAS 等相关领域的一流国际会议上。曾获 CoRL 2020 最佳系统论文奖,AAMAS 2021 Blue Sky Track 最佳论文奖。他连续多年担任 ICML, NeurIPS, ICRL,AAMAS,Nature, NMI, NC 等国际知名会议/期刊的 AC 或审稿人。
报告摘要:强化学习研究智能体如何通过与环境交互,利用经验改善长期行为。传统深度强化学习的常见设定以给定任务、交互接口和奖励机制下的策略优化为中心;大语言环境则使语言同时参与环境理解、行动组织、反馈评价与经验生成,推动学习对象从行为策略拓展到智能体自身的思考与学习过程。由此,如何行动、如何思考、如何学习,以及从怎样的环境中获取经验,成为相互关联的问题。本报告将从这一变化出发,讨论智能体、环境与学习机制之间的关系,分析认知与行动的协同学习、策略与评价的相互影响,以及开放环境中的经验积累所带来的理论与算法挑战,并结合我们在推理、元学习和环境扩展方面的探索,探讨智能体如何将交互经验转化为可积累、可迁移的能力,走向开放环境中的持续学习。
四、面向长程复杂任务的端侧智能体后训练方法
/ 陈颢天 /
嘉宾简介:陈颢天,上海交通大学人工智能学院助理研究员,研究方向为大语言模型智能体,聚焦于提升智能体长难任务的解决能力。曾入选清华大学水木学者计划与国家资助博士后研究人员计划,主持国家自然科学基金青年科学基金项目(C类)与中国博士后面上项目。深度参与 MiniCPM 系列模型的训练与发布,主导研发的 AgentCPM-Explore 深度搜索智能体大模型登上 GitHub Trending 榜单第二,作为项目初创核心成员构建的 RD-Agent 自动研发智能体获得 14000 余次星标与 1700 余次复刻。
报告摘要:随着 OpenClaw 的风靡,智能体正加速成长为“办实事”的个人助手并走向端侧。然而,端侧模型参数与算力受限,如何稳定完成步骤繁多、链条冗长、容错极低的复杂任务成为阻碍这一趋势发展的核心难题。本次报告聚焦端侧规模智能体的长难任务处理能力构建,剖析长程规划、持续执行、错误恢复与上下文管理中的核心难题,分享从环境搭建、模型训练到推理策略的系统性方法,探讨如何在紧凑的参数空间内,让“小”模型真正做成“大”事。
五、奖励分布匹配与环境学习缩放律
/ 朱学凯 /
嘉宾简介:朱学凯,上海交通大学计算机学院博士研究生,导师为林洲汉教授。研究方向为大语言模型后训练与强化学习,关注训练信号的可验证筛选、数据分布覆盖与奖励分布匹配,以及智能体在真实环境中的自我演进。曾作为实习生在美国微软雷德蒙研究院从事强化学习研究,现于字节跳动 Seed 团队从事自我演进智能体研究。曾获 1 作 ACL 2023 Area Chair Award。以第一作者在 ICLR、ICML、NAACL 发表多篇论文,提出面向大模型推理的奖励分布匹配方法 FlowRL;参与真实环境学习缩放律研究 EdgeBench 等工作。
报告摘要:大语言模型的强化学习后训练正在从离线数据走向真实环境中的持续交互与自我演进(self-evolving)。本报告围绕这一主线介绍两项工作。第一项工作针对奖励最大化方法容易压缩到少数主导解法、丢失其他可行推理路径的问题,把标量奖励转化为目标分布,用流平衡约束策略去匹配整个奖励分布,从而在强化学习训练中保留多样的推理路径。第二项工作关注模型部署后如何从真实环境中学习:构建了一组覆盖科学发现、软件工程、组合优化、形式化数学等领域的超长时程真实任务,让智能体在多层次反馈下长期运行,并基于大规模交互记录刻画环境学习的缩放规律。报告最后讨论两者的联系:训练阶段保留的解法分布决定了智能体在环境中可探索的空间,而环境反馈又反过来为策略更新提供可验证的信号,二者共同构成大模型自我演进的闭环。
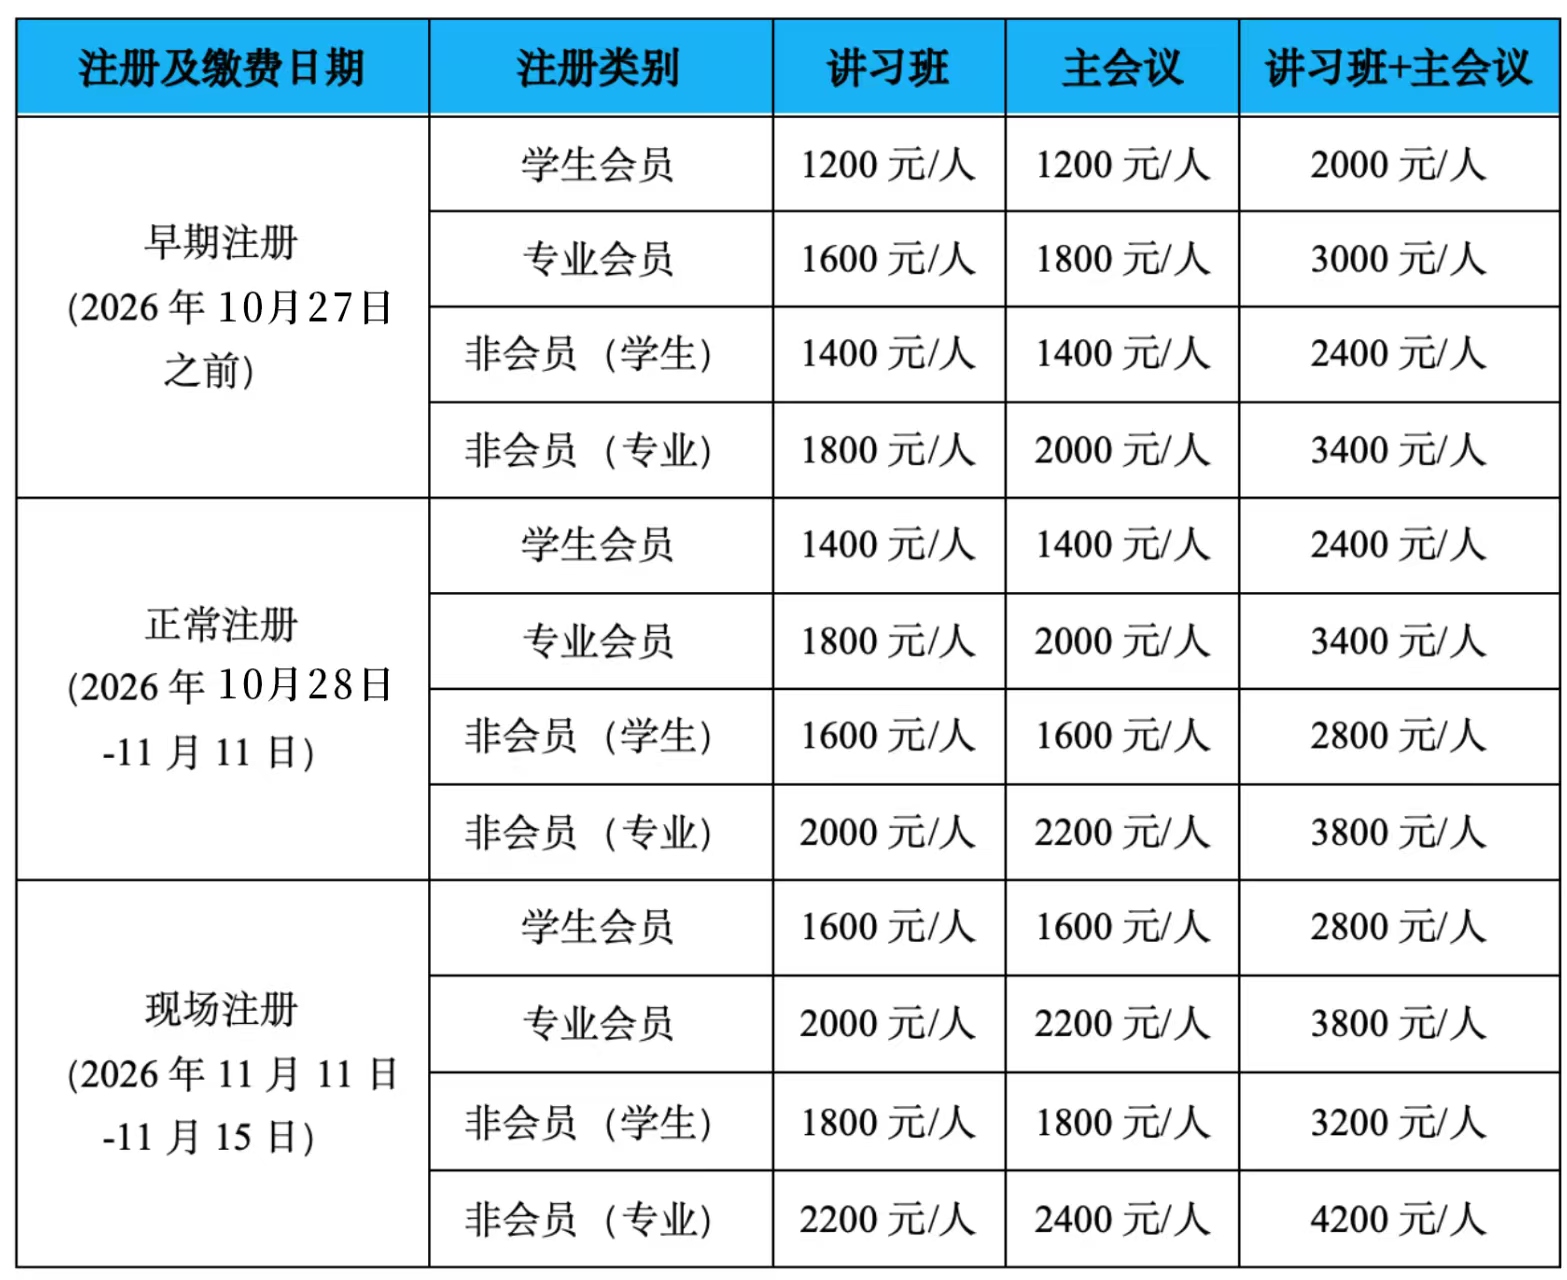
五、会议注册
注册网址:https://www.cipsc.org.cn/Learn/index.aspx?itemid=5442
会员查询:https://www.cipsc.org.cn/Memberinquiry/index.aspx
会员注册:https://www.cipsc.org.cn/Register.aspx
六、住宿酒店推荐
一、北京辽宁大厦(会议酒店)
具体酒店信息请参考往期推文:通知|SMP 2026 住宿及交通信息
二、周边协议酒店
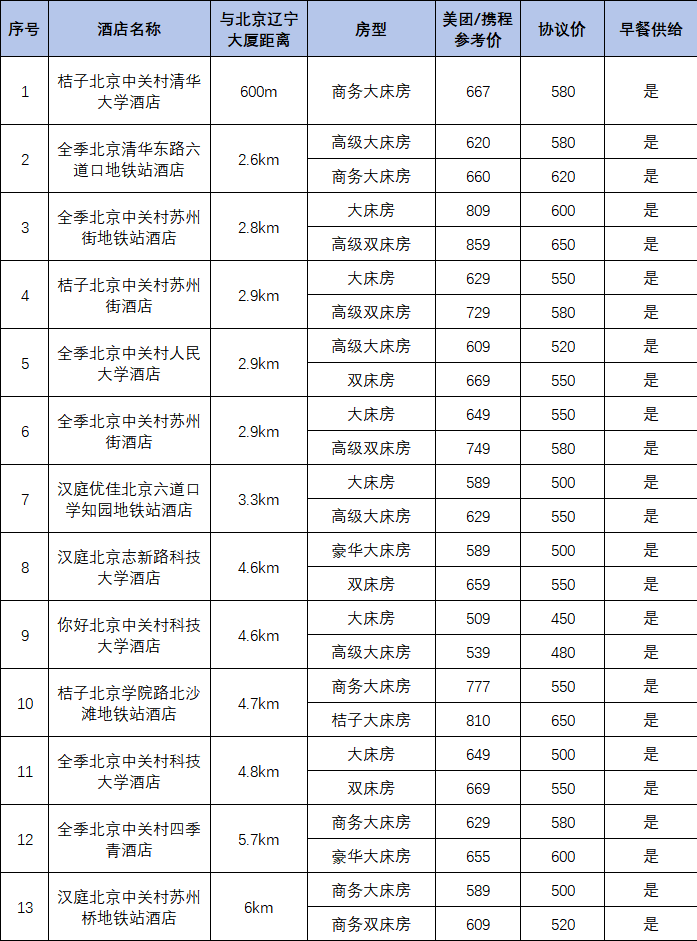
预订方式:统一电话联系酒店经理,报 SMP 2026 享受大会协议价格预订。
田经理:17718973646
陈经理:15010501105