报告题目:全球人工智能治理框架下中国人工智能立法思考与展望
姓名:申卫星,清华大学教授
个人简介及照片:申卫星,清华大学法学院教授、博士生导师,清华大学智能法治研究院院长。兼任教育部高等学校法学类专业教学指导委员会委员、中国法学会常务理事、中国法学会网络与信息法学研究会副会长、中国计算机学会(CCF)计算法学行业分会副主任。主要研究方向是民法学、计算法学与卫生法学,重点深耕数据产权、个人信息保护以及人工智能治理等领域。独著、合著专著、教材16部,发表学术论文110余篇。其中,多篇研究成果在AAAI、ACL、IJCAI等国际顶尖计算机领域学术会议上发表。曾为哈佛大学法学院富布赖特访问学者、德国洪堡学者,并先后在科隆大学、弗赖堡大学担任访问学者。
报告摘要:考察全球人工智能治理加速背景下中国人工智能立法的进展及其机会窗口,分析欧盟统一风险分级立法、美国分散治理与中国治理体系的差异,展望中国以“先立后优”推进基础性、要素性、行业性综合立法,通过发展与安全的动态平衡,让人工智能产业跑得更稳、更快、更远。
报告题目:大模型时代的智能生态安全
姓名:徐恪,清华大学教授
个人简介及照片:徐恪,清华大学英诺讲席教授、IEEE Fellow,中国电子学会会士,国家杰出青年科学基金及延续资助获得者。长期从事互联网体系结构与网络空间安全研究,近五年在计算机网络与安全领域顶级会议发表论文40余篇,获USENIX Security杰出论文奖和互联网防御奖等多项国际顶级会议论文奖。完成《网络空间安全原理与实践》等多部本科核心教材。以第一完成人获国家技术发明二等奖1项、中国电子学会科技进步一等奖3项;获第四届全国创新争先奖状,作为主要完成人获得国家科技进步一等奖、二等奖各1项。
报告摘要:随着人工智能由大语言模型向智能体加速演进,其能力正从认知理解向自主决策与任务执行拓展,逐步成为数字时代的新型生产力底座。同时,模型越狱、数据泄露、供应链漏洞、提示词注入和记忆投毒等安全风险日益凸显。报告了分析智能生态在系统运行、模型算法与服务应用三个层面的安全风险。提出了安全信息凝聚定律:在一定条件下,安全泛化能力由有效安全信息的凝聚程度及其对应的学习复杂度决定,而非单纯由原始数据规模决定。从安全信息凝聚定律出发,报告探究了协同防御体系构建思路和方法。
报告题目:当AI开始优化 AI:从算力底座到智能体时代的软件抽象
姓名:崔慧敏,中国科学院计算技术研究所研究员
个人简介及照片:崔慧敏博士,中国科学院计算技术研究所研究员,博士生导师,中科加禾创始人,任中科院计算所编译与编程实验室主任。曾主持过多项自然科学基金、973项目、科技部重点研发计划等国家级科研项目与课题,是2030新一代人工智能某编程项目的首席科学家。发表包括ASLPOS、MICRO、PLDI、PPoPP、OSDI、SC、TOCS、TPDS、TACO等编译和系统领域的顶级国际会议和期刊论文60余篇。
报告摘要:大模型的能力提升正改变 AI 系统的构建方式:AI 不再只是被优化的对象,也开始参与自身系统栈的优化,即递归自我改进(RSI)。其背景是,AI Infra 的性能与成本高度依赖底层算子、编译与调度等技术,而这些环节长期由人类专家手工设计,难以跟上模型与硬件的快速演进。本报告沿三个层次展开:
(1)AI Infra 底座——梳理 AI Infra 优化的共性机制与适用边界;
(2)RSI 实践——以 AI 自动生成算子、Infra 向国产芯片自动迁移、RSI 推理系统三项工作为例,讨论"AI 优化 AI"在正确性、性能收敛与可迁移性上的可行性与瓶颈;
(3)软件抽象——探讨当智能体成为程序的主要作者与使用者时,传统软件抽象应如何演进与重新设计。
报告旨在为跨学科听众勾勒一条从底层优化到上层抽象的演进线索,并给出值得共同探讨的开放问题。
报告题目:从长程执行到持续进化:探索自我演进的大模型智能体
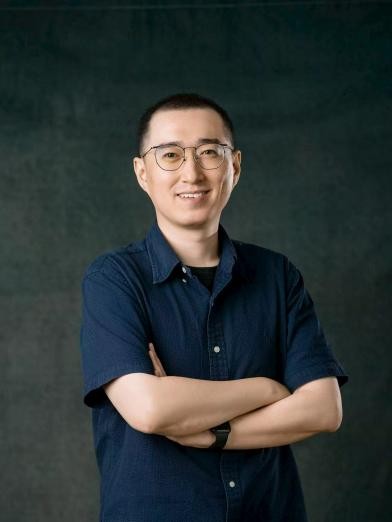
姓名:王翔,中国科学技术大学教授
个人简介及照片:王翔,中国科学技术大学教授、博导,国家高层次人才。研究方向包括大模型与智能体及应用,谷歌学术总引用3.6万余次,H-因子为70,2篇论文进入国际顶会SIGR近十年引用量最高与次高序列,并被斯坦福等国际知名高校课程与教材采用。2025年获人工智能顶会ICLR最佳论文奖,2024年获中国人工智能学会吴文俊人工智能自然科学一等奖、SIGR杰出青年奖、《麻省理工科技评论》MIT-TR35“35岁以下科技创新35人”2023年获国际基础科学大会前沿科学奖,入选AI2000全球人工智能最具影响力学者榜单,并在“信息检索与推荐”领域排名前三。担任TPAMI、TOIS等国际顶刊的副主编,并担任NeurIPS、ICML、ICLR等国际顶会领域主席。
报告摘要:随着大模型智能体由单轮问答向长周期复杂任务加速拓展,其自主执行时长与任务范围不断延伸,逐步成为科学发现与软件工程等领域的新型生产力引擎。然而,交互经验在长程执行中不断累积,却难以自动转化为智能体自身能力的提升。报告首先剖析长程智能体在外部记忆、模型策略与执行系统三个层面的能力瓶颈,指出持续进化的关键在于让智能体成为自己的优化者,将交互经验闭环沉淀至上述三类载体中。围绕这一核心思路,从三个层面探讨自我演进智能体的构建方法:在上下文层面,自主完成信息的提炼、回溯、视觉压缩与技能化;在参数层面,通过自演进评分准则与自验证学习内化推理能力;在系统层面,以可复用插件为单位递归改造执行脚手架,推动智能体从静态执行走向持续进化。最后,将进一步探讨迈向终身演进智能体的开放问题,包括如何走向主动发现能力短板、如何构建开放演化的训练环境,以及递归自我改进的能力边界与安全对齐。
报告题目:Co-GenAI: Decentralized Generative AI
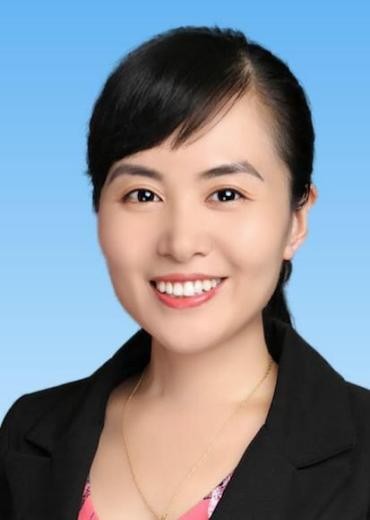
姓名:Hongxia Yang,Professor at The Hong Kong Polytechnic University (PolyU)
个人简介及照片:Prof. Hongxia Yang, Executive Director of PolyU Academy for Artificial Intelligence (PAAI) and Chair Professor at The Hong Kong Polytechnic University (PolyU), is the Founder and Chief Scientist of InfiX.ai. She earned her PhD from Duke University and has published over 150 papers in leading conferences and journals, and holds more than 50 patents. She has been awarded the highest prize of the 2019 World Artificial Intelligence Conference, Super AI Leader (SAIL Award), the second prize of the 2020 National Science and Technology Progress Award, the first prize of Science and Technology Progress of the Chinese Institute of Electronics in 2021, the Forbes China Top 50 Women in Science and Technology and Ministry of Education Science and Technology Progress Award First Class in 2022, AI 2000 Most Influential Scholar Award since 2023 and Top World 50 Women in AI and Web3 by CoinDesk in 2025. She used to work as the ByteDance US LLM Head, AI Scientist and Director in Alibaba Group, Principal Data Scientist at Yahoo! Inc and Research Staff Member at IBM T.J. Watson Research Center, joint adjunct professor at Zhejiang University Shanghai Advanced Research Institute respectively. She founded the foundation model teams at both Alibaba and ByteDance and is a pioneer in the field of Generative AI.
报告摘要:As artificial intelligence advances toward the AI-Native era, today's AI ecosystem remains constrained by centralized foundation models, high computational costs, fragmented domain knowledge, and limited utilization of domain-specific data. These challenges call for a more efficient, decentralized, and collaborative AI infrastructure. Co-GenAI (Collaborative Generative AI) introduces the Model over Models (MoM) paradigm to build the operating system for the AI-Native economy. By integrating FP8/FP4 low-bit training, model fusion, and multi-agent collaboration, Co-GenAI significantly reduces training and inference costs while enabling the development and continuous evolution of specialized models across diverse domains using distributed and local computing resources. Co-GenAI enables collaborative intelligence without centralizing sensitive data. Through model fusion, specialized models can exchange knowledge and evolve collaboratively, unlocking the value of domain-specific data and expertise. Its end-to-end infrastructure supports data processing, model development, deployment, and commercialization, while enabling AI asset ownership, provenance, and value distribution. By connecting domain knowledge, specialized models, and intelligent agents, Co-GenAI fosters open, trusted, and self-evolving intelligence ecosystems across healthcare, finance, energy, manufacturing, education, and beyond. It drives the fundamental shift from scaling individual models to scaling collaborative intelligence, laying the foundation for the AI-Native economy.